Migración a BigQuery y Preparación del Modelo
Fecha de entrega: 16/10/2024
Resumen
Haciendo uso de la GCP se cargo el dataset de COVID-19 a Drive como .csv debido al gran peso (cantidad de datos). Luego, haciendo uso del enlace compartido se nos permitio publicarlo en un dataset de BigQuery. Porteriormente, creamos una Cuenta de Servicio, en Google Cloud, con una llave .json para permitir la conexión a BigQuery desde un proyecto de dbt.
Migración de datos a BigQuery
- Extracción de información: descargamos de forma local los datos de Datos Abiertos Colombia - COVID-19 como .csv haciendo uso de la API.
- Publicación en Drive: los datos locales se subieron a Drive como .csv, aquí
- Inserción de los datos en un dataset de BigQuery: se creó un dataset de BigQuery y se subieron los datos de Drive con el ID `dm-09242024.raw.casos positivos covid-19`.
- Creación de una Cuenta de Servicio: para facilitar la conexxión a BigQuery desde un proyecto de dbt, se creó una Cuenta de Servicio con una llave .json de uso personal exclusivo para el proyecto de dbt.
Finalmente, replicamos el proceso de limpieza de los datos explicados en la sección de EDA. Se puede leer más al respecto aquí.
Justificación
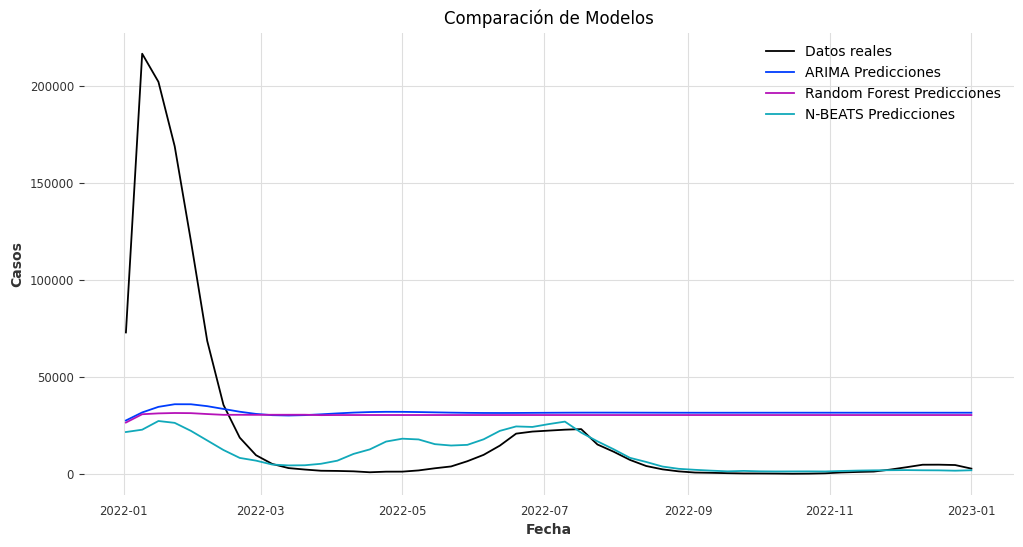
El modelo N-BEATS ha sido seleccionado para el proceso de predicción debido a su capacidad para captar patrones a largo y corto plazo en series temporales no estacionarias, como las de casos de contagio. En comparación con otros modelos, N-BEATS demostró ser el más coherente con la dinámica del sistema, obteniendo mejores métricas en términos de error promedio y precisión al capturar las fluctuaciones observadas en los datos históricos de contagio.
- Una de las principales fortalezas de N-BEATS es su flexibilidad para modelar series temporales sin requerir supuestos previos sobre su estacionalidad o tendencia. Al ser un modelo de tipo caja negra basado en redes neuronales, se adapta mejor a patrones no lineales, lo que lo hace adecuado para datos de COVID-19 que pueden experimentar cambios abruptos. Además, su arquitectura permite la descomposición de la serie en componentes que facilitan la interpretación de la tendencia general y de las fluctuaciones, mejorando así la capacidad de predicción.
- No obstante, una debilidad de N-BEATS es su alta demanda computacional, ya que necesita más recursos y tiempo de procesamiento en comparación con modelos clásicos como ARIMA. Su naturaleza de caja negra también dificulta la interpretación directa de los coeficientes o parámetros, lo que puede limitar el análisis profundo de factores específicos en la dinámica de la pandemia. Además, el modelo puede ser sensible a hiperparámetros y a la configuración de su red, lo que requiere un proceso de ajuste cuidadoso para evitar sobreajuste.
Resultados y evaluación
| RMSE | MAPE | MAE | |
|---|---|---|---|
| ARIMA | 48110.055749 | 1952.676660 | 34534.448158 |
| Random Forest | 48376.643100 | 1877.890660 | 33985.714528 |
| N-BEATS | 44599.627735 | 195.454731 | 17446.887940 |